Comparativa de modelos para programar: Claude Opus 4.8, OpenAI GPT-5.6, Kimi K2.7 y Qwen3.7 Max
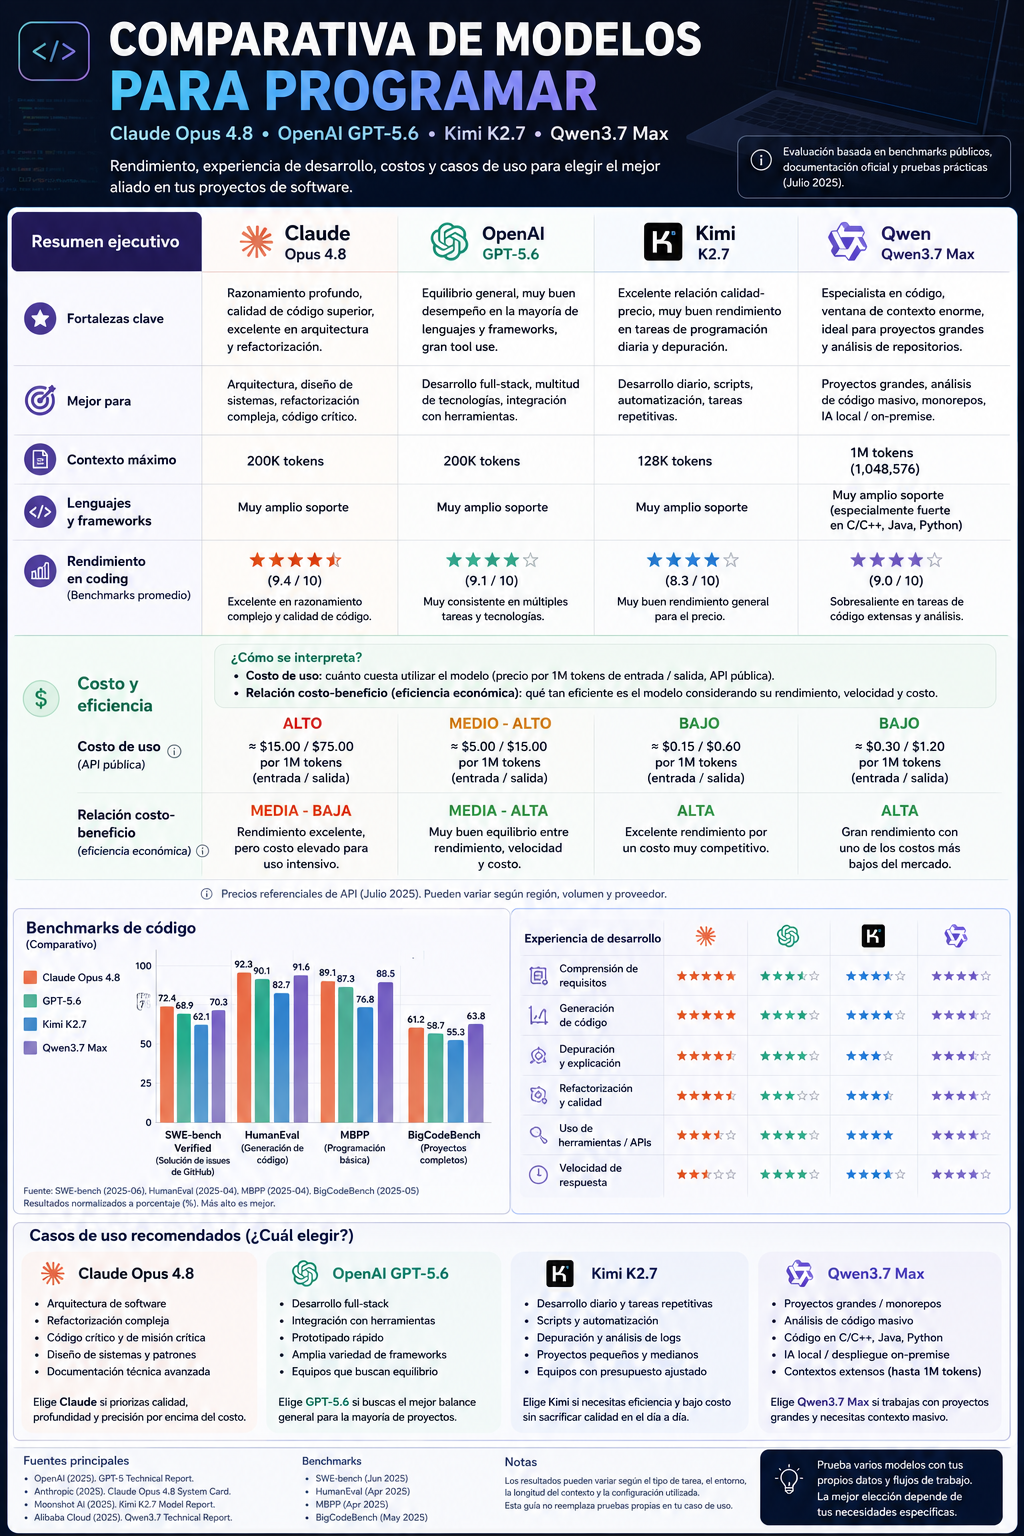
Infografía en español que compara cuatro modelos de IA para programación con resumen ejecutivo, costos y eficiencia, benchmarks de código, experiencia de desarrollo y casos de uso recomendados. Evaluación señalada como de julio de 2025.
- Complejidad
- Introductoria
- Lectura
- 5 min de lectura
- Publicada
Sobre esta infografía
Resumen editorial del contenido visible
Modelos comparados: Claude Opus 4.8, OpenAI GPT-5.6, Kimi K2.7, Qwen3.7 Max.
La evaluación se indica como basada en benchmarks públicos, documentación oficial y pruebas prácticas (julio de 2025).
Fortalezas clave (síntesis)
Claude: razonamiento profundo y alta calidad de código, fuerte en arquitectura y refactorización.
GPT-5.6: equilibrio general y desempeño sólido en múltiples lenguajes; gran ecosistema y herramientas.
Kimi: muy buena relación calidad‑precio para tareas de programación diaria y depuración.
Qwen: especialista en código con ventana de contexto muy grande; apto para proyectos extensos y análisis de repositorios.
Mejor para (síntesis)
Claude: arquitectura de software, soluciones complejas y refactorización crítica.
GPT-5.6: desarrollo full‑stack, integración multicloud y trabajo con herramientas.
Kimi: desarrollo cotidiano, scripts y automatización no crítica.
Qwen: proyectos grandes/monorepos y uso local u on‑prem; fuerte en C/C++, Java y Python.
Contexto máximo declarado: Claude 200K tokens; GPT‑5.6 200K; Kimi 128K; Qwen 1M.
Rendimiento en coding (promedio mostrado en la tabla): Claude 9.4/10; GPT‑5.6 9.1/10; Kimi 8.3/10; Qwen 9.0/10.
Costos y eficiencia (categorización visible)
Claude: costo de uso alto; relación costo‑beneficio media‑baja (rinde excelente pero caro para uso intensivo).
GPT‑5.6: costo medio‑alto; relación costo‑beneficio media‑alta (buen equilibrio).
Kimi: costo bajo; relación costo‑beneficio media‑alta.
Qwen: costo bajo; relación costo‑beneficio alta.
Benchmarks de código listados: SWE‑bench Verified, HumanEval, MBPP, BigCodeBench.
Se muestran barras comparativas por modelo (valores exactos poco legibles en el gráfico) y una nota de que los resultados son promedios (0 a 10, más alto es mejor).
Experiencia de desarrollo: matriz de estrellas para comprensión de requisitos, generación y depuración de código, refactorización/arquitectura, uso de herramientas/APIs y velocidad.
Claude y GPT‑5.6 aparecen con valoraciones altas en la mayoría de categorías; Kimi con buen rendimiento general por precio; Qwen fuerte en tareas extensas de código.
Casos de uso recomendados
Claude: arquitectura, refactorización compleja, código crítico, diseño de sistemas y revisiones avanzadas.
GPT‑5.6: desarrollo full‑stack, prototipado rápido, integración de frameworks y trabajo con herramientas.
Kimi: tareas diarias, automatización por scripts, depuración y análisis con presupuesto ajustado.
Qwen: proyectos con mucho contexto, análisis de código masivo, repositorios grandes y despliegue local/on‑prem.
Notas visibles: precios referenciales de API (julio 2025) y que pueden variar por región, volumen y proveedor.
Se sugiere probar varios modelos y elegir según necesidades específicas.
Ideas clave
La infografía compara cuatro modelos de IA de código: Claude Opus 4.8, GPT‑5.6, Kimi K2.7 y Qwen3.7 Max.
Contexto máximo declarado: 200K tokens para Claude y GPT‑5.6, 128K para Kimi y 1M para Qwen.
Rendimiento promedio en coding mostrado: Claude 9.4, GPT‑5.6 9.1, Kimi 8.3 y Qwen 9.0 sobre 10.
Coste y eficiencia: Claude se posiciona como alto costo; GPT‑5.6 medio‑alto; Kimi y Qwen bajos con mejor relación costo‑beneficio.
Claude y GPT‑5.6 destacan en comprensión, generación y refactorización; Kimi rinde bien para el día a día; Qwen sobresale en tareas extensas con mucho contexto.
Casos de uso sugeridos: Claude para arquitectura y refactorización crítica; GPT‑5.6 para full‑stack y herramientas; Kimi para automatización y depuración; Qwen para monorepos y despliegue local.
El gráfico de barras incluye SWE‑bench Verified, HumanEval, MBPP y BigCodeBench, con nota de promedios 0–10.
La pieza enfatiza que los precios son referenciales de julio de 2025 y pueden variar por región y proveedor.
Etiquetas
- comparativa de modelos ia
- programación asistida por ia
- benchmarks de código
- tokens de contexto
- costos de api
- eficiencia económica
- experiencia de desarrollo
- casos de uso de ia
- desarrollo de software
- evaluación julio 2025
- modelos generativos
- análisis de repositorios